
“개발자와 기업이 한국어 환경에서도 가속 효과를 얻을 수 있도록 한글날에 맞춰 한국어 드래프트 모델을 공개했다.”
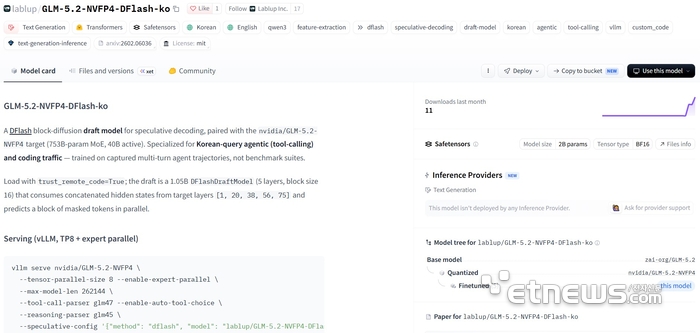
신정규 래블업 대표의 이 한마디가 이번 발표의 성격을 잘 보여줍니다. 래블업은 한국어 기반 거대언어모델(LLM)의 답변 속도를 높이는 드래프트 모델 ‘GLM-5.2-NVFP4-DFlash-ko’를 오픈소스로 공개했다고 12일 밝혔어요. 실제 공개일은 한글날인 9일이었습니다.
드래프트 모델이 뭔가요
쉽게 말하면 ‘빠른 조수’예요. AI가 답을 한 글자씩 만드는 대신, 작은 모델이 다음에 올 토큰 여러 개를 미리 예측하고 큰 모델이 이를 한 번에 검증하는 방식입니다. 조수가 초안을 빠르게 쓰고 선생이 한 번에 채점하는 셈이죠. 이 구조를 드래프트 모델, 여러 토큰을 동시에 만드는 방식을 디플래시(DFlash)라고 불러요.
영어 모델의 한계를 한국어로 메웠다
기술의 핵심은 한국어입니다. 그동안 영어 기반 드래프트 모델은 한국어 작업에서 가속 효과가 떨어지는 문제가 있었어요. 래블업은 한국어 데이터로 모델을 따로 학습해 추측 적중률을 끌어올렸습니다. 한국어 에이전트 트래픽에서 측정한 평균 수락 길이(MAL)는 2.77로, 영어 모델과 비슷한 가속 성능을 냈다고 회사는 설명합니다. 평균 수락 길이는 예측한 토큰 가운데 실제로 채택된 평균 개수를 뜻하는데, 이 값이 클수록 가속 효과가 크다는 의미예요.
기반 모델은 중국 즈푸(Z.ai)의 GLM-5.2를 엔비디아 4비트 부동소수점 형식(NVFP4)으로 구동할 때 함께 쓰는 구조예요. 메모리는 적게 쓰면서 속도를 챙기는 조합인 셈이죠. 래블업은 오픈소스 AI 인프라 소프트웨어 ‘백엔드.AI’로 알려진 회사로, 이번 모델은 자사가 쌓아온 추론 최적화 기술을 한국어 영역으로 넓힌 결과물입니다.
코스닥 상장 절차도 밟는다
래블업은 여기에 그치지 않고 약 110억 파라미터 규모의 한국어 디퓨전 언어 모델도 개발 중입니다. 로컬 기기에서 에이전트 작업을 돌리는 온디바이스 모델이 목표이고, 학습에는 B200 그래픽처리장치(GPU) 64장 규모 클러스터를 활용해요. 클라우드가 아닌 기기 안에서 AI를 돌리려면 모델을 가볍고 빠르게 만드는 기술이 관건이기 때문입니다.
회사는 최근 금융위원회에 증권신고서를 제출하고 코스닥 상장 절차에 착수했습니다. 공모 주식수는 총 218만주, 희망 공모가는 2만원에서 2만3000원입니다. 13일부터 19일까지 기관투자자 대상 수요예측을 진행할 예정이에요.
래블업은 이번 모델을 오픈소스로 풀어 개발자들이 자유롭게 쓸 수 있게 했습니다. 한국어 서비스를 만드는 스타트업 입장에서는 추론 비용을 낮출 카드를 하나 더 얻은 셈이에요. 상장을 앞두고 기술력을 증명하는 성격도 겸합니다.
드래프트 모델은 최근 국내외 AI 기업이 앞다퉈 내놓는 분야이기도 합니다. 같은 모델을 조금 더 싸게 돌리는 기술이 서비스 원가를 좌우하기 때문인데, 한국어에 맞춰 학습한 사례는 아직 드물었어요.
희망 공모가 기준 공모 규모는 436억원에서 501억원 수준입니다. 확보한 자금은 모델 개발과 인프라 확장에 투입될 전망이에요.
국내 AI 업계에서는 한국어 특화 추론 최적화가 아직 비어 있는 틈새라는 평가가 나옵니다. 글로벌 모델의 성능 경쟁과 별개로, 한국어 서비스를 실제로 돌리는 기업 입장에서는 응답 속도와 비용이 곧 경쟁력이기 때문입니다.
이번 발표는 한국 AI 스타트업의 승부처가 ‘모델을 만드는 일’에서 ‘모델을 빠르고 싸게 돌리는 일’로 옮겨가고 있다는 신호로 읽혀요. 인프라 소프트웨어에서 쌓은 경험을 한국어 모델로 넓히는 흐름이 실제 매출로 이어지는지는 상장 이후 실적에서 확인될 텐데요. 수요예측 결과와 온디바이스 모델 공개 시점이 다음 이정표가 될 전망입니다.
- 원문: 전자신문 — 래블업, ‘한국어 AI 추론 속도 향상’ 드래프트 모델 공개
- 작성: sw4u 9시뉴스 안나영 / 2026-10-12 21:05